3 Klassische Stochastische Prozesse
3.1 Elementare Begriffe der Wahrscheinlichkeitstheorie
3.1.1 Eindimensionale Zufallsvariable
Sei \(X\) eine Zufallsvariable (auch stochastische Variable), die entweder
diskret, \(X \in \{x_1, x_2, \ldots\}\), z. B. Augen des Würfels oder quantenmech. Zustand,
oder kontinuierlich, \(X \in \mathbb{R}\), z. B. Position eines Teilchens,
ist, mit Wahrscheinlichkeitsverteilung \(\rho_X\).
Es gilt:
\(\rho(x_i) \geq 0\) bzw. \(\rho(x) \geq 0\) (nicht-negativ),
\(\sum_i \rho_X(x_i) = 1\) bzw. \(\int \mathrm{d}x\, \rho(x) = 1\) (normiert).
Wir definieren den Erwartungswert \begin{equation*} \left\langle O(X) \right\rangle \;:=\; \sum_i O(x_i)\, \rho_X(x_i) \qquad \text{bzw.}\qquad \int \mathrm{d}x\, O(x)\, \rho(x).\end{equation*}
Wichtige Begriffe:
Mittelwert: \(\left\langle X \right\rangle\)
Varianz: \(\operatorname{Var}(X) := \left\langle X^2 \right\rangle - \left\langle X \right\rangle^2 = \left\langle (X-\left\langle X \right\rangle)^2 \right\rangle\)
Standardabweichung: \(\sigma(X) := \sqrt{\operatorname{Var}(X)}\)
\(n\)-tes Moment: \(\left\langle X^n \right\rangle\)
charakteristische Funktion: \(\displaystyle \phi_X(k) := \left\langle \mathrm{e}^{\mathrm{i}k X} \right\rangle\) \[\text{Zusammenhang:}\quad \phi_X(k) = \sum_{n=0}^\infty \frac{(\mathrm{i}k)^n}{n!}\, \left\langle X^n \right\rangle, \qquad \left\langle X^n \right\rangle = \frac{1}{\mathrm{i}^n}\, \partial_k^n \phi_X \Big|_{k=0}.\]
Kumulanten-erzeugende Funktion: \(S_X(k) := \ln \phi_X(k)\)
entsprechend: \(n\)-te Kumulante \[C_n(X) := \frac{1}{\mathrm{i}^n}\, \partial_k^n S_X \Big|_{k=0}.\]
Man sieht: \begin{align*} C_0(X) &= \ln \underbrace{\phi_X(k{=}0)}_{=1} = 0, \\ C_1(X) &= \frac{1}{\mathrm{i}}\, \frac{1}{\phi_X(0)}\, \phi_X'(0) = \left\langle X \right\rangle.\end{align*} Allerdings: \(C_2(X) = \sigma^2(X)\), \(C_3(X) = \left\langle X^3 \right\rangle - 3\left\langle X \right\rangle\left\langle X^2 \right\rangle + 2\left\langle X \right\rangle^3\), …
Warum \(S\) statt \(\phi\)?
\(S \;\leftrightarrow\;\) Wirkung in Feldtheorie
Entwicklung in \(C_n\) konvergiert oft schneller
Beispiel (Gauß-Verteilung). \[\rho(x) = \frac{1}{\sqrt{2\pi}\,\sigma}\, \exp\!\left[-\frac{1}{2}\, \frac{(x-\left\langle x \right\rangle)^2}{\sigma^2}\right].\] Es gilt \[\phi_X(k) = \int_{-\infty}^{+\infty} \mathrm{d}x\, \rho(x)\, \mathrm{e}^{\mathrm{i}k x} = \mathrm{e}^{-\frac{1}{2} k^2 \sigma^2 + \mathrm{i}k \left\langle X \right\rangle},\] und damit \[C_{n>2} = 0, \qquad C_1 = \left\langle X \right\rangle, \qquad C_2 = \sigma^2.\]
3.1.2 Wichtige Verteilungen
Betrachte das Bernoulli-Experiment, d. h. zwei mögliche Ergebnisse \(A, B\) mit \(\rho_A = p\), \(\rho_B = q = 1-p\):
Münze, \(A = \text{Kopf}\), \(B = \text{Zahl}\), \(p = q = \tfrac{1}{2}\)
Spin in Magnetfeld, \(A = \uparrow\), \(B = \downarrow\)
Teilchen in Teilvolumen \(V_p < V\) \(\;\Rightarrow\; p = V_p/V\), \(q = (V - V_p)/V\)
Führe \(N\)-mal dieses Experiment unabhängig durch, dann ist die Wahrscheinlichkeit, dass \(n \leq N\)-mal \(A\) eintritt,
\begin{equation*} \rho_B(n) \;=\; \underbrace{\frac{N!}{n!\,(N-n)!}}_{=\binom{N}{n}\,=\,\#\text{Möglichkeiten}\, n\, \text{mal}\, A\, \text{„zu ziehen“}}\, p^n\, q^{N-n} \qquad \text{„BinomialVerteilung“}\end{equation*}
Es gilt:
\(\displaystyle \sum_{n=0}^{N} \rho_B(n) = \sum_{n=0}^{N} \binom{N}{n} p^n q^{N-n} = (p+q)^N = 1 \; \checkmark\)
\(\displaystyle \left\langle n \right\rangle = \sum_{n=0}^{N} n\, \rho_B(n) = \sum_{n=0}^{N} p\, \frac{\partial}{\partial p}\, \rho_B(n) = p\, \frac{\partial}{\partial p} \sum_{n=0}^{N} \rho_B(n) = p\, \frac{\partial}{\partial p} (p+q)^N = \underline{N p}.\)
\(\displaystyle \sigma(n) = \sqrt{N p q}\) \[\Longrightarrow \quad \frac{\sigma(n)}{\left\langle n \right\rangle} \propto \frac{1}{\sqrt{N}} \to 0 \quad (N \to \infty) \qquad \text{relative Breite wird kleiner.}\]
Zwei Grenzfälle etwas genauer.
(i) \(N \to \infty\) bei \(x = N p = \left\langle n \right\rangle\) fix (also \(p \to 0\) wie \(x/N\)). [z. B. radioaktiver Zerfall]
Es gilt \begin{align*} \rho_B(n) &= \frac{N!}{n!\,(N-n)!} \left(\frac{x}{N}\right)^n \left(1 - \frac{x}{N}\right)^{N-n} \\ &= \frac{x^n}{n!}\, \underbrace{\frac{N!}{N^n\,(N-n)!}}_{\xrightarrow{N\to\infty} 1}\, \underbrace{\left(1-\tfrac{x}{N}\right)^{N}}_{\to\, \mathrm{e}^{-x}}\, \underbrace{\left(1-\tfrac{x}{N}\right)^{-n}}_{\to\, 1}\end{align*} und daher
\begin{equation*} \rho_B(n) \;\sim\; \rho_P(n) \;=\; \frac{x^n\, \mathrm{e}^{-x}}{n!} \qquad \text{Poisson-Verteilung}\end{equation*}
Sie hängt nur von einem Parameter \(x\) ab, mit
\(\displaystyle \sum_{n=0}^{\infty} \rho_P(n) = \mathrm{e}^{x}\, \mathrm{e}^{-x} = 1 \; \checkmark\)
\(\left\langle n \right\rangle = x\)
\(\sigma_n = \sqrt{x}\) [macht Sinn, denn \(\sqrt{Npq} = \sqrt{x}\sqrt{1-x/N} \to \sqrt{x}\)]
(ii) \(N \to \infty\), feste \(p, q\):
\begin{equation*} \rho_B(n) \;\sim\; \rho_G(n) \;=\; \frac{1}{\sqrt{2\pi}\, \sigma_n}\, \exp\!\left(-\frac{(n - \left\langle n \right\rangle)^2}{2\sigma_n^2}\right) \qquad \text{Gauß-Verteilung}\end{equation*}
bekannt als „De Moivre–Laplace-Theorem“.
Beweis: z. B. mit Stirling-Formel; hier: siehe unten.
3.1.3 Mehrdimensionale Zufallsvariablen
Seien \(X_1, X_2, \ldots, X_n\) Zufallsvariablen, diskret oder kontinuierlich, mit gemeinsamer Wahrscheinlichkeitsverteilung \(\rho_{X_1 X_2 \ldots X_n}\).
Es gilt:
\(\rho_{X_1 X_2 \ldots X_n}(x_1, x_2, \ldots, x_n) \geq 0\),
\(\displaystyle \sum_{x_1, x_2, \ldots, x_n} \rho_{X_1 X_2 \ldots X_n}(x_1, x_2, \ldots, x_n) = 1\) bzw.
\(\displaystyle \int \mathrm{d}x_1\, \mathrm{d}x_2 \ldots \mathrm{d}x_n\, \rho_{X_1 X_2 \ldots X_n}(x_1, x_2, \ldots, x_n) = 1\).
Wir definieren den Erwartungswert \begin{equation*} \left\langle O(X_1, X_2, \ldots, X_n) \right\rangle \;:=\; \int \mathrm{d}x_1\, \mathrm{d}x_2 \ldots \mathrm{d}x_n\, O(x_1, \ldots, x_n)\, \rho_{X_1 X_2 \ldots X_n}(x_1, \ldots, x_n),\end{equation*} bzw. entsprechend für den diskreten Fall.
Reduzierte Verteilungsfunktion (\(m < n\)): \begin{equation*} \rho_{X_1 X_2 \ldots X_m}(x_1, \ldots, x_m) = \int \mathrm{d}x_{m+1} \ldots \mathrm{d}x_n\, \rho_{X_1 X_2 \ldots X_n}(x_1, x_2, \ldots, x_n).\end{equation*}
Wichtige Begriffe:
Kovarianz: \(\displaystyle \operatorname{Cov}(X_i, X_j) := \left\langle (X_i - \left\langle X_i \right\rangle)(X_j - \left\langle X_j \right\rangle) \right\rangle\) [\(= \operatorname{Var}(X_i)\) für \(i = j\)]
\(X_i\) und \(X_j\) unabhängig \(\;\Longleftrightarrow\; \rho_{X_i X_j}(x_i, x_j) = \rho_{X_i}(x_i)\cdot \rho_{X_j}(x_j)\) \begin{align*} \Rightarrow\quad \operatorname{Cov}(X_i, X_j) &= \int \mathrm{d}x_1\, \mathrm{d}x_2 \ldots \mathrm{d}x_n\, (x_i - \left\langle x_i \right\rangle)(x_j - \left\langle x_j \right\rangle)\, \rho_{X_1 X_2 \ldots X_n}(x_1, \ldots, x_n) \\ &= \int \mathrm{d}x_i\, \mathrm{d}x_j\, \rho_{X_i X_j}(x_i, x_j)\, (x_i - \left\langle x_i \right\rangle)(x_j - \left\langle x_j \right\rangle) \\ &\stackrel{\text{unabh.}}{=} \Bigl(\int \mathrm{d}x_i\, \rho_{X_i}(x_i)\, (x_i - \left\langle x_i \right\rangle) \Bigr)\, (i \to j) \\ &= \underbrace{\left\langle X_i - \left\langle X_i \right\rangle \right\rangle}_{=0}\, \underbrace{\left\langle X_j - \left\langle X_j \right\rangle \right\rangle}_{=0} = 0\end{align*}
Funktionen von Zufallsvariablen: \(Z = f(X_1, \ldots, X_n)\) \[\text{damit gilt:} \quad \rho_Z(z) = \left\langle \delta\bigl(z - f(X_1, \ldots, X_n)\bigr) \right\rangle\]
Beispiel (\(n=2\), \(Z = X + Y\) und \(X, Y\) unabhängig). \begin{align*} \rho_Z(z) &= \int \mathrm{d}x\, \mathrm{d}y\, \rho_X(x)\, \rho_Y(y)\, \delta\!\bigl(z - (x+y)\bigr) \\ &= \int \mathrm{d}x\, \rho_X(x)\, \rho_Y(z-x) \quad \textit{[macht intuitiv Sinn]}\end{align*} Konkret: \(\rho_X(x) = \rho_Y(y)\) ist die Rechteck-Verteilung auf \([0,1]\) (siehe Abbildung 3.1), also \[\rho_Z(z) = \int_0^1 \mathrm{d}x\, \rho_Y(z-x) = \begin{cases} z & 0 \leq z \leq 1, \\ 2-z & 1 \leq z \leq 2, \\ 0 & \text{sonst}, \end{cases}\] d. h. eine Dreiecks-Verteilung auf \([0,2]\).
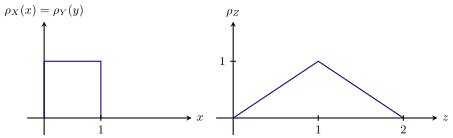
Abb. 3.1: Faltung zweier Rechteck-Verteilungen ergibt eine Dreiecks-Verteilung. bedingte Wahrscheinlichkeit: \[\rho_{X_1 \ldots X_m}(x_1, \ldots, x_m \mid \underbrace{X_{m+1} = x_{m+1}, \ldots, X_n = x_n}_{\text{gegeben, dass dies „gezogen wurde“}}) = \frac{\rho_{X_1 \ldots X_n}(x_1, \ldots, x_n)}{\rho_{X_{m+1} \ldots X_n}(x_{m+1}, \ldots, x_n)}.\]
Daraus folgt der Satz von Bayes, hier für \(n = 2\): \[\rho_X(x \mid Y = y) = \frac{\rho_Y(y \mid X = x)\, \rho_X(x)}{\rho_Y(y)}\] Was man einfach erhält aus zweifachem Anwenden der obigen Beziehung: \[\rho_X(x \mid Y = y) = \frac{\rho_{XY}(x, y)}{\rho_Y(y)} = \frac{\rho_Y(y \mid X = x)\, \rho_X(x)}{\rho_Y(y)}\] Spezialfall: \(X, Y\) unabhängig, dann \(\rho_{XY}(x,y) = \rho_X(x)\rho_Y(y)\), und \[\rho_X(x \mid Y = y) = \frac{1}{\rho_Y(y)}\, \rho_{XY}(x, y) = \rho_X(x) \qquad \text{wie zu erwarten.}\]
Beispiel (Multidimensionale Gauß-Verteilung). Schreibe \(\vec{X} = (X_1, X_2, \ldots, X_n)\). \[\rho_{\vec{X}}(\vec{x}) = \frac{\sqrt{\det(A)}}{(2\pi)^{n/2}}\, \exp\!\left(-\frac{1}{2}\, (\vec{x} - \vec{x}_0)^T A\, (\vec{x} - \vec{x}_0)\right), \quad A \in \mathbb{R}^{n\times n},\ \text{symmetrisch, positiv definit}.\] Es gilt:
\(\displaystyle \left\langle X_j \right\rangle = \int \mathrm{d}^n x\, \rho_{\vec X}(\vec x)\, \bigl(x_j - (\vec x_0)_j + (\vec x_0)_j\bigr) = (\vec{x}_0)_j + \underbrace{\int \mathrm{d}^n \xi\, \rho_{\vec X}(\vec\xi + \vec x_0)\, (\vec\xi)_j}_{=\,0\ \text{(gerade in }\vec\xi\text{)}}, \quad \vec\xi = \vec x - \vec x_0\) \[\Longrightarrow \quad \left\langle \vec X \right\rangle = \vec x_0.\]
\(\operatorname{Cov}(X_i, X_j) = (A^{-1})_{ij}\) [Übungsaufgabe]
Dieser Abschnitt endet hier vorläufig – es folgt mehr.